中国の面壁智能(ModelBest)は、スマートフォンなどの端末上で動くマルチモーダルモデル「MiniCPM-V 4.7」を発表しました。35B-A3Bと1Bという規模の異なる2つのバージョンを同時に提供します。クラウドにデータを送らずに端末内で処理できる点が特徴で、プライバシー保護と応答遅延の削減につながるとしています。
ポイント
- 35B-A3Bと1Bの2バージョンを公開
- 35B-A3BはMiniCPM-Vシリーズ初のMoE(複数の専門家モデルを組み合わせる方式)モデル
- iPhone 17 Pro Max上で3GBのメモリを使い、毎秒13トークン以上(トークンはAIが文章を処理する単位)の生成速度を達成
- iOS、Android、HarmonyOSに対応し、Intel、AMD、Arm、瑞芯微、後摩などのチップに対応
- ファインチューニング手法「SRFT」を公開
35B-A3Bの特徴
35B-A3Bは、MiniCPM-Vシリーズで初めてMoEを採用したモデルです。新たに「LES(前向きエキスパートスケジューリング)」と呼ぶ推論加速技術を組み合わせました。これにより、端末上で性能を落とさずに動くオープンソースのMoEモデルとしては業界で初めてだとしています。
実機での性能も示されています。iPhone 17 Pro Max上で、3GBのメモリのみを使って毎秒13トークン以上のデコード速度を記録しました。データをクラウドに送る必要がなくなるため、プライバシーと遅延の両面で利点があるということです。
対応環境とファインチューニング
対応するプラットフォームはiOS、Android、HarmonyOSの3つです。チップはIntel、AMD、Arm、瑞芯微、後摩などに対応し、モバイル端末からローカルコンピューティングまで幅広くカバーします。
面壁智能はあわせて、ファインチューニング手法「Self-Replay Fine-Tuning(SRFT)」を公開しました。開発者が低コストで機能を拡張し、学習済みの能力が失われる「忘却」を抑えながら二次開発を行えるようにする狙いです。
性能比較
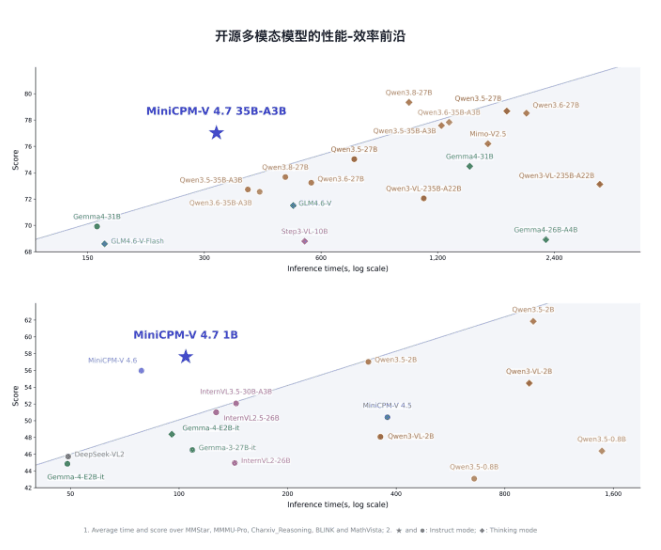
35B-A3BはInstructモードにおいて、Qwen3.6 35B-A3Bより短い推論時間で高い総合スコアを獲得したとしています。1Bバージョンも前バージョンの4.6から性能が向上し、総合スコアと推論効率の両方でQwen3.5 0.8Bを上回りました。
端末向けモデルの小型化が進む中、今回のバージョンは大規模モデルをMoE化してスマートフォンで動かすための敷居をさらに下げるものだとしています。
