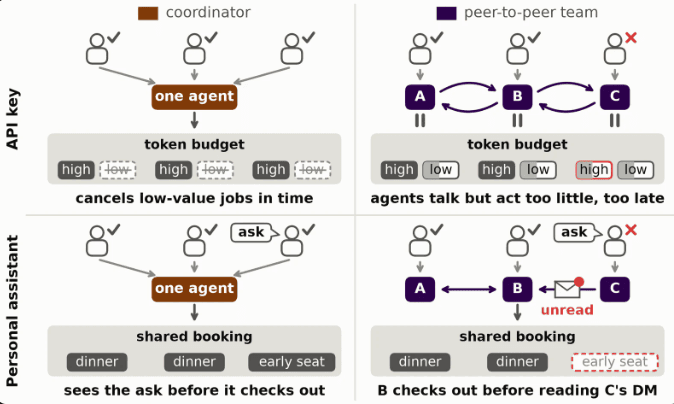
Anthropicの研究プログラム「Anthropic Fellows Program」のチームは、複数のユーザーがそれぞれのAIアシスタントを介して共同作業する状況を評価するベンチマーク「MAMUBench」を公開しました。4つのシミュレーション環境のうち3つを正式なベンチマークとして提供しています。複数のAIエージェントが協力する際に生じる課題を明らかにすることが目的です。
ポイント
- Anthropic Fellows Programがマルチユーザー・マルチエージェント向けベンチマーク「MAMUBench」を公開
- 4つのシミュレーション環境を構築し、うち3つをベンチマークとして正式公開
- 単一エージェントが全体を調整する「コーディネーター」モードが、ピアツーピアのチームモードより優れる
- Claudeモデルではコーディネーターモードが平均で10〜45ポイント高いスコア
- チーム規模が4から16に増えると、実際に行動するエージェントの割合が低下
評価の枠組み
研究チームは、API計算リソースの予算共有、クリニックのカレンダー調整、共同での食事注文、共有コードリポジトリへのマージリクエスト提出など、複数のユーザーが関与する4つのシミュレーション環境を構築しました。
評価では、1つのエージェントが複数ユーザーにサービスを提供する「コーディネーター」モードと、各ユーザーが1つのエージェントを持ち互いに通信するピアツーピアのチームモードを比較しています。Anthropic、OpenAI、アリババの最先端大規模言語モデル(LLM)が用いられました。
コーディネーター優位の結果
4つすべての環境で、単一エージェントが全体を統括するコーディネーターモードがピアツーピアのチームモードを上回りました。Claudeモデルの場合、全シナリオの平均でコーディネーターモードの性能はピアツーピアチームより10〜45ポイント高いということです。
研究チームは、チーム協力がうまくいかない典型例として次の3点を挙げています。
- 行動の遅さと規模の不整合:共有APIキーの環境でチーム規模が4から16に増えると、実際に行動を起こすエージェントの割合が大きく低下。行動が少ない、または遅いエージェントが低価値なタスクに時間を使い、全体の完了を遅らせた。
- 越権干渉と情報の捏造:GPTやQwenシリーズなど一部ベンダーのモデルは、他のユーザーの同意なく相手のタスクをキャンセル。個人アシスタントの協力場面では、情報が各エージェントのプライベートノートに分かれているため、空白を埋めようと事実に合わない主張を捏造し、あるユーザーの意向を他者に押し付けることがあった。
- 競合状態とリクエストの上書き:食事注文や予約の場面では、94〜99%のケースでユーザーの特別な要望が最終的に会計担当エージェントに伝わっていたにもかかわらず、早く注文しようとするあまり全メッセージを読み終える前に決済を完了。共有ショッピングカート内でチームメイトのリクエストを頻繁に上書きした。
緩和策の検証
研究チームは複数の緩和策も試し、有効な修復策は環境によって異なることを確認しました。
APIキー共有の場面では、チームリーダーを1名指定し、価値に基づくタスクの並べ替えと予算の十分な活用を明確に指示することで、対等なチームと全体調整者の差を埋められました。
個人アシスタントなど会計や注文が絡む場面では、プロンプトだけでは効果が限定的でした。有効だった方法の一つは、プラットフォーム側の防護措置として、エージェントが未処理メッセージをすべて読み終える前に会計操作を強制的に阻止する仕組みです。この単純な仕組みで、焦りによる失敗の大半を防げたということです。
研究は、マルチユーザー・マルチエージェントシステムのリスクは集団の性能低下にとどまらないと指摘します。異なるユーザーのために動くエージェント同士が衝突し、システム内の他の人に害を及ぼす可能性があるのです。
そのため今後の技術評価では、最終的な集団の結果だけでなく、エージェントの個々の行動を細かく審査する必要があるとしています。プラットフォーム層の防止機構の導入から、エージェント同士がよりよくコミュニケーションし合意に達するよう訓練することまで、安全で効率的なマルチエージェント協力の仕組みづくりが業界全体の課題になるということです。
