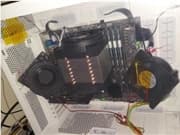
人工知能のモデル規模が拡大を続けるなか、数兆パラメータ級の大規模モデルは高価なハイエンドGPUクラスタがなければ動かせないのが一般的です。そんな常識に挑んだ事例がコミュニティで共有されました。GPUを搭載していない40コアの旧型サーバーだけで、Moonshot AI(月之暗面)の2.8兆パラメータモデル「Kimi K3」の動作に成功したというものです。
ポイント
- 使用したのは40コアの第3世代Xeonスケーラブルプロセッサ搭載の旧型サーバーで、GPUは非搭載
- Kimi K3は総パラメータ数2.8兆の混合エキスパート(MoE)モデル。1トークンあたり約1040億パラメータが活性化する
- 公式スペックのコンテキスト長は104万トークン
- 生産終了したIntelのOptane Persistent Memory 200シリーズを組み合わせ、1枚あたり最大512GBを確保
- 1ビット量子化時の生成速度は毎秒0.85トークン、Direct Access(DAX)モードをオフにすると最大毎秒1.5トークン
ハードウェアの制約と対策
Kimi K3は総パラメータ数2.8兆の混合エキスパート(MoE)モデルです。各トークンで活性化されるのは約1040億パラメータにとどまりますが、公式スペックのコンテキスト長は104万トークンに達します。
この規模のデータを扱うには、1ビット量子化まで圧縮しても数百GBのメモリが必要です。一般家庭用マザーボードの搭載限界を超えるため、投稿者は40コアの第3世代Xeonスケーラブルプロセッサを搭載したサーバーに、NVIDIAが生産終了したOptane Persistent Memory 200シリーズを組み合わせました。1枚あたり最大512GBという大容量を確保する構成です。
ソフトウェアの調整
ソフトウェア面ではllama.cppを利用しました。Optane Persistent MemoryをApp Directモードに設定し、ハードディスクのキャッシュとしてシステムに任せるのではなく、プログラムが直接読み書きするメモリとして使っています。
ただし、この非主流の低コスト構成には速度面の代償があります。1ビット量子化での実測生成速度は毎秒0.85トークンです。Direct Access(DAX)モードをオフにすると、速度は最大でも毎秒1.5トークンにとどまります。
