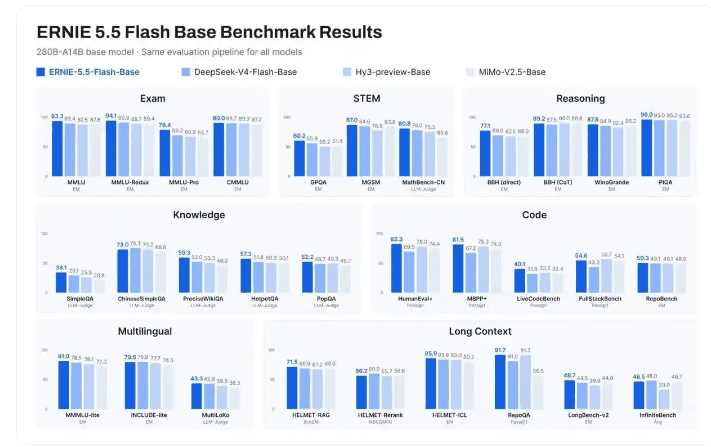
百度は11月5日、新しい基盤モデル「文心5.5Flash Base」をオープンソース化したと発表しました。知識や推論、数学、コード、多言語、長文コンテキストなど複数のベンチマークテストで、同サイズモデルの最高性能(SOTA)を更新したとしています。DeepSeek-V4-Flash-BaseやHy3-preview-Baseなどの同類モデルを上回る性能だということです。
モデルの規模と仕様
文心5.5Flash BaseはMoE(複数の専門家ネットワークを組み合わせるアーキテクチャ)を採用しています。総パラメータ数は2800億、活性化パラメータは140億です。
33.5兆トークン(AIが文章を処理する単位)を用いて事前学習を完了しています。事前学習時のコンテキスト長は最大128Kで、ファインチューニングと推論の段階では最大100万トークンのコンテキストを扱えます。
効率化のための技術
文心5.5Flash Baseは効率性を重視し、システム層で複数のアルゴリズムの改良を行っています。
アテンション機構にはLatent-Gated Sparse Attentionを導入しました。HCAとMLAを組み合わせて履歴情報を圧縮し、履歴位置へ細かくアクセスします。低ランクゲート付きアテンションにより、ゲート射影の重みパラメータを75%削減しました。仮想ヘッドアテンションによって表現力も高めています。
エキスパートの振り分けにはMulti-Router Latent MoEを採用しました。複数の独立したルーターによって、エキスパート選択の有用性を改善しています。
学習目標にはECHOを導入しました。バックボーンの最終層を再利用して後続トークンの予測を学習することで、追加のMTPモジュールを不要にしています。
大規模モデルの基盤としては、分散Muonオプティマイザを最適化しました。FlashMask-4アテンション演算子を提供することで、大規模学習における通信とVRAM(GPUのメモリ)の利用効率を高めています。
開発者への影響
大規模モデルの競争は、モデル能力、学習効率、シーン革新が協調して進む方向に向かっています。文心5.5Flash Baseのオープンソース化は、専門モデル開発のハードルを下げるとともに、開発者がカスタマイズした専門モデルを構築するための効率的な技術基盤を提供するとしています。
