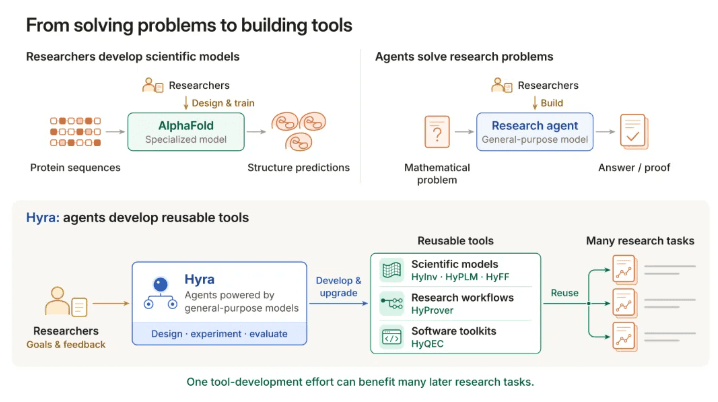
テンセントの研究チーム「混元(Hunyuan)」は、科学研究向けのAIエージェント「Hyra 2.0」を発表しました。AIが科学ツールやモデルの研究開発そのものを支援し、得られた成果を次の研究で再利用できる仕組みを目指します。従来の「AIが問題を解く」段階から、研究の進め方自体を変える試みとして注目されます。
ポイント
- 混元は科学ツール開発に特化したAIエージェント「Hyra 2.0」を発表
- タンパク質設計や量子誤り訂正など7つの先端領域で成果を公開
- 社内の研究開発環境と接続し、実験の設計から検証まで自動化
- 次世代モデルの事前学習や推論最適化にも活用
背景:AIによる科学研究の自動化
混元は約3か月前、科学研究向けのAIエージェント「Hyra 1.0」を公開しました。オープンソースモデル「Hy3」を基に、50年以上未解決だった数学の難題を完全自動で解いたとしています。
その後、海外のAI企業も数学や理論計算機科学の分野で相次いで成果を競っています。混元は次の課題を「ツールのアップグレード」と位置づけました。
3層構造のエージェント設計
Hyra 2.0は、研究の役割を3層に分けています。全体を統括する「Overall」、個別の研究課題を担当する「Mission」、コードの実行や実験を担う「Worker」です。
システムはテンセント社内の研究開発環境に接続されています。企業向けチャットツール「WeChat」での要件調整や、計算基盤への実験投入、コード管理までを一貫して行えるということです。
また、検証済みの手法を「Books」と呼ぶ知識ベースに蓄積し、再利用可能なスキルとして後続の研究に引き継ぐ仕組みも備えています。
7領域での初期成果
Hyra 2.0はすでに7つの先端領域でツールやモデルの開発を完了し、成果をオープンソースコミュニティで公開しています。
- タンパク質逆折畳み(HyInv):196万パラメータのモデルをゼロから訓練。生成速度は業界標準の「ProteinMPNN」と比べて57倍になったとしています。
- タンパク質言語モデル(HyPLM):6.5億パラメータの「HyPLM-Flash」を開発。訓練に使ったトークン(AIが文章を処理する単位)は累計7260億で、同類モデルの5分の1から8分の1にとどめました。
- 原子レベル基盤モデル(HyFF):230万から12億パラメータまでの5規模を用意し、83種類の元素に対応。約6万原子の水チャネルタンパク質膜系のシミュレーションなどを実現しました。
- 数学証明ワークフロー(HyProver):数学者と協力し、丘成桐氏の円周作用予想と五次元Petty等距点予想の証明を検証・整理しました。
- 量子誤り訂正(HyQEC):量子符号[488, 123, 22]の構築と検証に成功。符号化効率は従来の首位より約48%向上したとしています。
- ロボットハンド設計:5本指を手のひら周りに配置した「旋梯手」を自律的に発見。平均回転速度は最適設計より28.6%速い3.277rad/sでした。
- RISC-Vプロセッサ「香山」の最適化:ベンチマーク「SPEC CPU2006」のGHz当たりスコアを5.79%改善。未公開の不具合10件なども発見しました。
今後の展開
混元はHyra 2.0を、次世代「Hy」モデルの事前学習や事後学習、推論最適化にも活用しています。実験サイクルの短縮や、高品質な訓練データの自動生成によるコスト削減を進める方針です。
同社は、研究で得た知見を再利用可能なツールやワークフローとして蓄積することで、科学の領域を継続的に広げられるとしています。
